>Petits modèles locaux: déployer un SLM sur Raspberry Pi
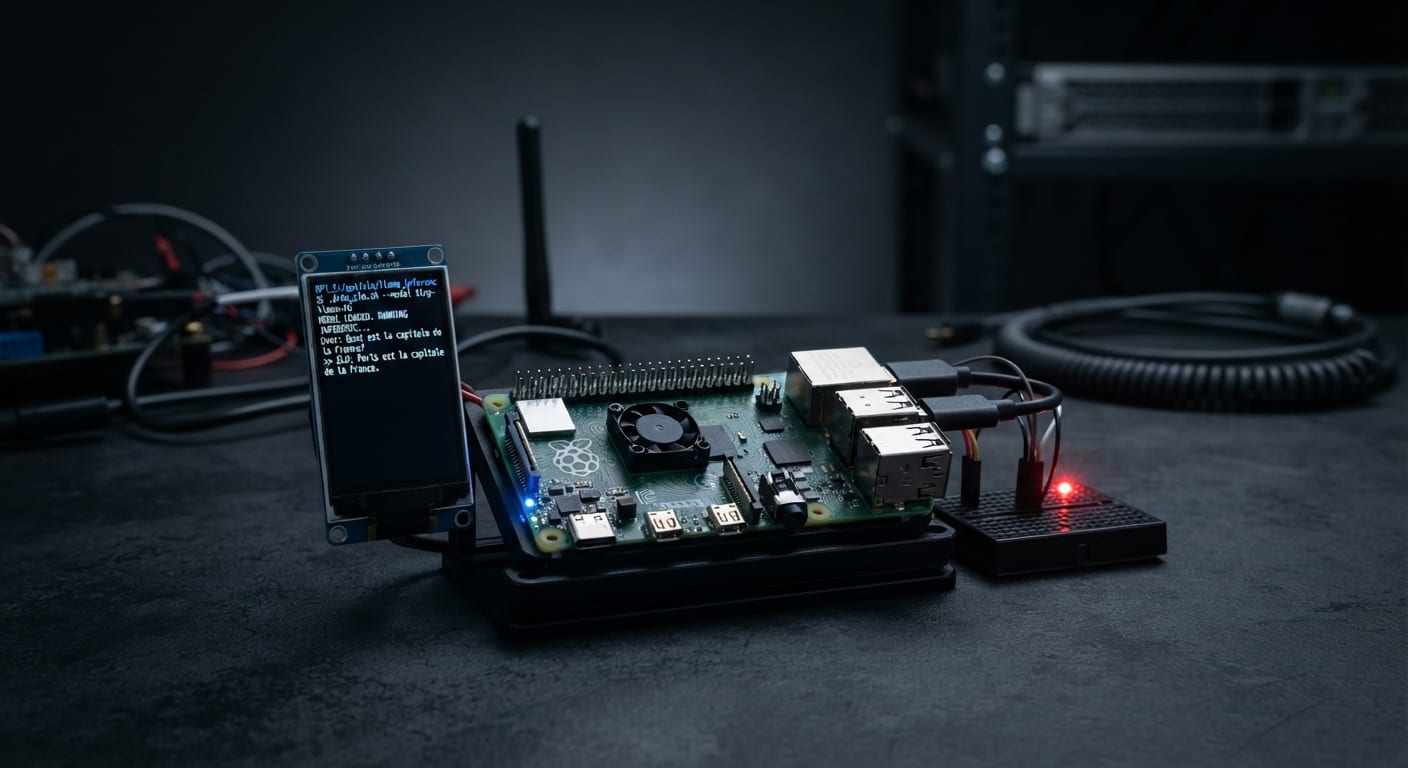
Les gros modèles reçoivent toute l’attention, mais la révolution silencieuse de 2026, c’est le petit: les SLM (Small Language Models), les modèles de 1 à 14 milliards de paramètres qui tournent sur un Raspberry Pi. Il y a un an, des modèles open-weight était une génération derrière et moins chers. Aujourd’hui, pour les tâches de traitement (résumés, commits, extraction, analyse de logs), les meilleurs petits modèles sont dans la marge d’erreur des modèles fermés de l’an dernier, et ils promettent 10 à 60 fois moins cher.
Et surtout: ils tournent chez moi, sans envoyer mes données nulle part.
Pourquoi un SLM plutôt qu’un gros modèle
Dans mon article sur les agents locaux avec Ollama, je montrais qu’on pouvait faire tourner un agent complet en local.
Le modèle frontière: grosses tâches de raisonnement, beaucoup de contexte, génération de code complexe. Mais l’essentiel du travail d’IA courant, ce n’est pas ça. C’est:
- résumer un article ou un diff,
- rédiger un message de commit,
- renommer des variables et refactorer,
- analyser des lignes de log pour y trouver l’erreur,
- réécrire ou extraire du texte,
- poser des premiers jets de documentation.
Tout ça, c’est du grunt tier: du volume, des tâches répétitives, aucun besoin de raisonnement profond. Envoyer ce trafic vers un modèle cloud, c’est payer cher (en tokens et en données) pour un résultat qu’un modèle de 7B à la maison fait aussi bien.
Le clivage est devenu net: gros modèle pour le rare et le complexe, SLM local pour le fréquent et le simple. Le routeur de modèles est devenu une pratique standard et n’est plus une curiosité.
Le matériel
Le Raspberry Pi 5 avec 8 ou 16 Go de RAM est un candidat capable de faire tourner de bon modèles. Un Pi 4 (4 Go) suffit pour les modèles de 1 à 3B quantifiés. Le Pi est limité: pas de GPU exploitable pour l’inférence, tout passe par le CPU et la bande passante mémoire unifiée.
En pratique, sur un Pi 5:
| Modèle | Taille quantifié | RAM nécessaire | Fluide? |
|---|---|---|---|
| Qwen 0.5B / Gemma 1B (Q4) | ~0,5 - 0,8 Go | 2 Go | Oui, très réactif |
| Phi-3-mini 3.8B (Q4) | ~2,3 Go | 4 Go | Oui, confortable |
| Qwen2.5 7B (Q4) | ~4,7 Go | 8-16 Go | Correct, ~8-12 tok/s |
| 14B (Q4) | ~9 Go | 16 Go | Limite, la RAM saigne |
Ce qui compte vraiment, c’est la bande passante mémoire (le Pi 5 tourne autour de ~30 Go/s), parce que l’inférence décode token par token et chaque token a besoin de parcourir tout le modèle. Le nombre de tokens par seconde est à peu près divisé par leur taille. Un 7B à ~10 tokens/s, c’est lent pour du chat interactif mais parfait pour du traitement par lots la nuit.
Installer le runtime
Pas de surprise: on reste sur Ollama, la même stack que l’article précédent. L’installation sur Raspberry Pi OS (64 bits) tient en une ligne:
curl -fsSL https://ollama.com/install.sh | sh |
Puis on tire les modèles utiles, en version quantifiée. Pour le Pi, on préfère les quantifications Q4_K_M: le meilleur ratio qualité/taille pour la mémoire limitée.
# Le polyvalent 3.8B |
Vérifier que ça répond, en branchant le service à mon dashboard de monitoring Beszel pour surveiller la RAM:
ollama serve & |
Paramétrer pour la patience
Les SLM veulent un contexte court et des instructions nettes. Sur un Pi, deux réglages changent tout.
Pour éviter que la RAM ne monopolise, on limite le contexte: un modèle 7B en Q4 avec 4K de contexte, c’est ~5 Go de RSS. À 32K de contexte, ça grimpe vite au-delà de 8 Go et ça finit en swap, donc en tokens par seconde catastrophiques. On garde un contexte court pour du traitement, long uniquement pour la génération.
curl http://localhost:11434/api/generate -d '{ |
Le paramètre temperature bas compte énormément. Pour du résumé, de l’extraction, de la reprise d’infos, on veut du déterministe, pas de la créativité. 0.2 ou moins, c’est la différence entre un commit message propre et un commit qui invente des choses.
Mesurer avant de jurer
Deux métriques: le tokens par seconde (débit) et la latence au premier token (temps avant la première réponse). La seconde compte plus qu’on ne croit pour l’usage interactif.
import requests, time |
Sur un Pi 5, je mesure régulièrement:
- phi3:mini: ~25 tok/s, très utilisable en chat,
- qwen2.5:7b: ~9-11 tok/s, utilisable en traitement par lots,
- qwen2.5:0.5b: ~80 tok/s, instantané.
Le cas d’usage qui change tout: le RAG embarqué
Le vrai gagnant, c’est la combinaison SLM + RAG sans réseau. J’avais monté un RAG avec Ollama et PostgreSQL. Le même montage tourne sur le Pi pour les documents techniques de la maison: il n’y a que la génération de réponse qui passe par le SLM, l’embedding et la recherche restant dans pgvector.
Le pipeline complet:
# docker-compose.yml |
La réponse à la question “comment je déploie une mise à jour sur ce serveur?” sort directement de ma doc technique, sans quitter le LAN. La donnée sensible reste à la maison, ce qui est exactement le genre de sobriété que je voudrais en général sur mon infra.
Les limites à connaître
Il y a des plafonds de verre:
- Raisonnement limité: pour du debug multi-étapes ou du code complexe, le 7B bloque. Le Pi ne remplace pas un gros modèle cloud, il le décharge des tâches simples.
- Contexte court: oubliez le document de 200 pages dans le prompt. On passe par du RAG, pas par un contexte géant.
- Français passable: les modèles 0.5-1B sont nettement meilleurs en anglais. Pour du français soigné, on monte à 7B.
- Batterie et chauffe: 30 minutes d’inférence en continu, et le Pi chauffe. Un ventilateur ou un dissipateur devient nécessaire.
Le verdict
Le SLM sur Raspberry Pi, ce n’est pas un jouet: c’est une brique d’infrastructure. Il prend en charge le volume répétitif à coût nul (électricité et hardware déjà en place), sans exfiltrer la moindre donnée. Et il rend l’IA réactive: pas de latence réseau, pas de quota, pas de carte bleue.
La prochaine étape, c’est de spécialiser: un SLM par tâche au lieu d’un seul modèle polyvalent, et de les faire travailler ensemble.