MCP vs function calling : quelles différences pour un développeur ?
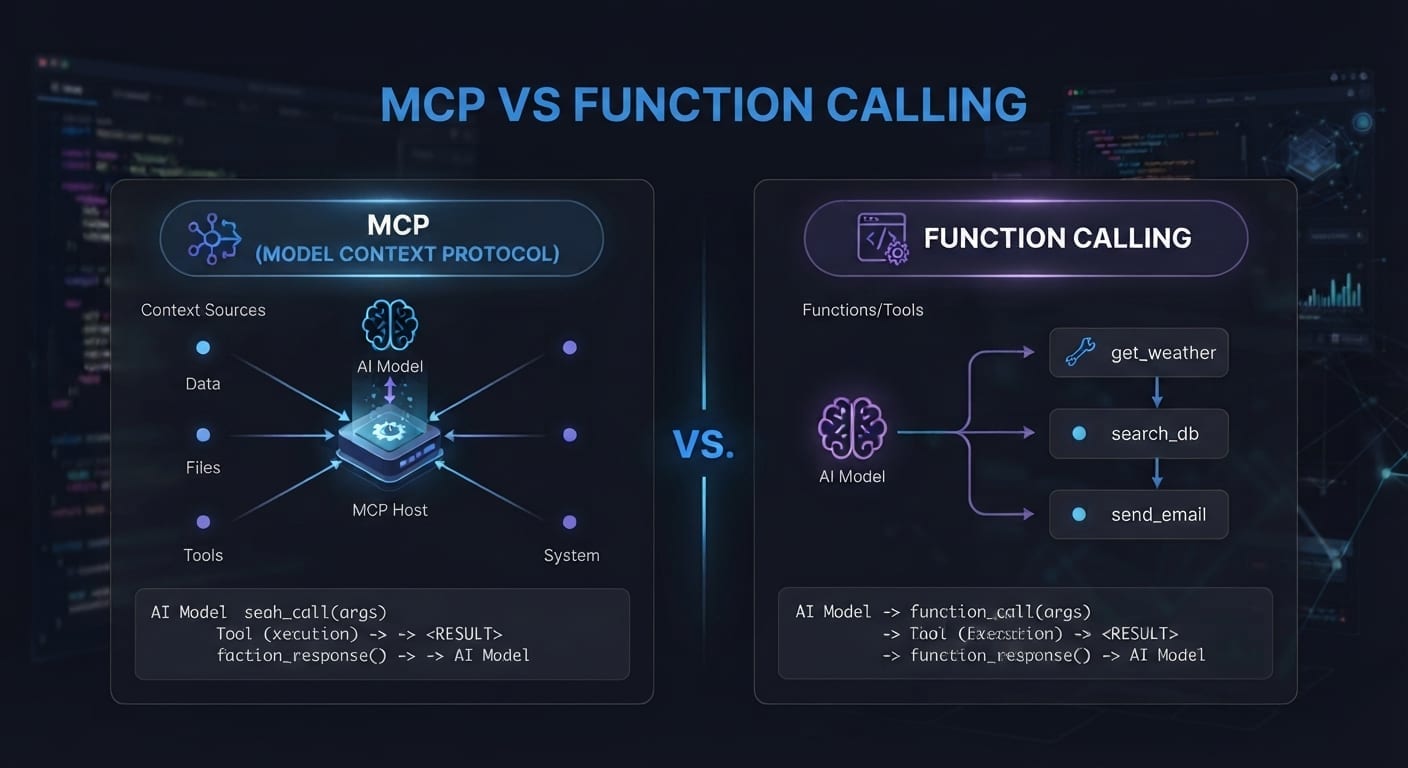
Avec l’explosion des agents IA en 2025-2026, deux approches dominent pour permettre à un LLM d’interagir avec le monde extérieur : le function calling (appel de fonctions) et le MCP (Model Context Protocol). Les deux résolvent le même problème fondamental, à savoir donner à un modèle la capacité d’appeler des outils externes, mais ils le font de manière radicalement différente.
J’ai commencé à utiliser le function calling dès que les premiers modèles l’ont supporté. C’était simple, efficace, et ça répondait au besoin. Puis le MCP est arrivé et j’ai passé un moment à me demander si c’était une évolution nécessaire ou juste du bruit. Après plusieurs mois d’expérience avec les deux, j’ai une réponse claire : les deux ont leur place, mais pour des raisons différentes.
Le function calling, retour aux bases
Le function calling est un mécanisme intégré au modèle. Quand un développeur définit des “outils” (functions) dans sa requête API, le modèle peut, au lieu de répondre en texte brut, répondre avec un objet JSON structuré indiquant quelle fonction appeler et avec quels arguments.
Comment ça marche concrètement
Voici un exemple simplifié avec l’API OpenAI :
import openai |
Le modèle retourne quelque chose comme :
{ |
L’application côté serveur intercepte cet appel, exécute la fonction, et retourne le résultat au modèle :
weather_data = get_weather("Lyon") |
Le modèle reçoit la donnée et génère une réponse en langage naturel : “Il fait 22°C à Lyon avec un ciel dégagé.”
Les forces du function calling
- Simple à mettre en place : une seule API, un seul framework, pas de service supplémentaire.
- Faible latence : pas de protocole de transport supplémentaire, pas de négociation.
- Intégration native : les modèles modernes ont un support intégré, c’est optimisé par les fournisseurs.
- Contrôle total : le développeur définit exactement les fonctions disponibles, les arguments attendus, et le comportement en cas d’erreur.
Les limites
Le problème arrive quand on veut réutiliser les outils. Chaque application doit redéfinir les mêmes fonctions. Si vous avez un outil “accéder à une base de données”, vous devez le réimplémenter dans chaque application, pour chaque modèle, dans chaque framework. C’est de la duplication par conception.
De plus, le function calling est tightly coupled au fournisseur de modèle. Les schémas d’outils OpenAI, Anthropic et Google ont des différences de syntaxe, même si le principe est identique. Changer de modèle implique parfois d’adapter le code d’intégration.
Le MCP : un protocole, pas un mécanisme
Le Model Context Protocol, lancé par Anthropic en fin 2024 et devenu un standard ouvert en 2025, change fondamentalement l’architecture. Au lieu de définir les outils dans l’application, on les expose via un serveur MCP qui parle un protocole standardisé. L’application (le client MCP) découvre les outils disponibles et les transmet au modèle.
L’architecture MCP
Chaque serveur MCP est un processus indépendant qui expose des outils via un protocole JSON-RPC. Le client MCP se connecte, découvre les outils disponibles, et les transmet au modèle comme des function definitions.
Exemple concret : un serveur MCP filesystem
Voici ce que ressemble un serveur MCP minimal en Python avec le SDK officiel :
from mcp.server.fastmcp import FastMCP |
C’est tout. Ce serveur expose deux outils, read_file et list_directory, via le protocole MCP. N’importe quel client MCP peut s’y connecter et les utiliser, qu’il s’agisse de Claude Desktop, d’une application Python, d’un agent Node.js ou de n’importe quel autre client compatible.
Le protocole en détail
La communication suit le standard JSON-RPC 2.0. Le client peut effectuer trois opérations principales :
1. Découverte des outils (tools/list)
{ |
Réponse du serveur :
{ |
2. Appel d’un outil (tools/call)
{ |
3. Ressources (resources/list)
Le MCP ne se limite pas aux outils. Il définit aussi le concept de “ressources” (des données contextuelles) et de “prompts” (des templates de prompts réutilisables). C’est une extension au-delà du simple function calling.
Les différences concrètes pour un développeur
La théorie c’est bien, mais concrètement, qu’est-ce qui change quand on code ?
Couche d’abstraction
| Aspect | Function Calling | MCP |
|---|---|---|
| Définition des outils | Dans l’application | Dans un serveur dédié |
| Transport | HTTP (API du modèle) | JSON-RPC (stdio ou SSE) |
| Découverte | Statique (liste définie au départ) | Dynamique (tools/list à la connexion) |
| Réutilisation | Non (par application) | Oui (un serveur = N clients) |
| Couplage au modèle | Fort (syntaxe par fournisseur) | Faible (protocole standard) |
| Complexité initiale | Faible | Moyenne (setup serveur) |
| Latence supplémentaire | Aucune | Quelques ms (transport) |
La réutilisation : le vrai game changer
Considérons un scénario concret. Vous avez un outil “recherche dans les tickets Jira“. Avec le function calling, vous définissez la fonction search_jira dans chaque application qui en a besoin. Trois applications, trois définitions identiques, trois maintenances.
Avec MCP, vous créez un serveur MCP jira-tools qui expose search_jira. Les trois applications se connectent au même serveur. Une seule maintenance, une seule source de vérité, un seul endroit à mettre à jour quand l’API Jira change.
C’est le principe du client-serveur appliqué aux outils d’IA. Ça peut paraître comme un surcoût, mais dans un écosystème avec plusieurs agents ou plusieurs applications, ça devient vite indispensable.
Le couplage au fournisseur
Avec le function calling, changer de modèle (par exemple d’OpenAI à Anthropic) peut nécessiter d’adapter les schémas d’outils. Les différences sont souvent mineures (nommage des champs, format des réponses) mais elles existent et créent une dette technique.
Avec MCP, les outils sont définis une seule fois dans le serveur. Le client MCP se charge de la traduction vers le format attendu par le modèle. Changer de modèle ne touche pas la définition des outils.
# Avec le function calling, le schéma peut varier selon le fournisseur |
Quand utiliser quoi ?
Function calling : le bon choix quand…
- Application mono-modèle, mono-utilisateur : un assistant personnel, un chatbot de service client, un prototype rapide.
- Latence critique : chaque milliseconde compte, pas de place pour un protocole supplémentaire.
- Pas de réutilisation prévue : les outils sont spécifiques à cette application, personne d’autre n’en aura besoin.
- Équipe petite : pas de capacité à maintenir des serveurs MCP dédiés.
MCP : le bon choix quand…
- Plusieurs applications partagent les mêmes outils : c’est le cas le plus courant en entreprise.
- Écosystème d’agents : plusieurs agents collabèrent et ont besoin des mêmes capacités.
- Indépendance vis-à-vis du modèle : vous voulez pouvoir changer de fournisseur sans réécrire les outils.
- Outils complexes : une connexion à une base de données, un accès à un système de fichiers distant, une intégration avec un service externe. Ce sont des composants lourds qui ne doivent pas être dupliqués.
- Ouverture à la communauté : vous voulez partager vos outils avec d’autres développeurs, comme on partage des packages npm ou des bibliothèques Python.
Le piège du “MCP pour tout”
Attention à ne pas tomber dans le piège inverse. Le MCP n’est pas toujours la bonne solution. Pour un outil simple, utilisé par une seule application, le function calling est plus léger et plus direct. Ajouter un serveur MCP pour exposer une seule fonction qui retourne la météo, c’est de l’over-engineering.
Le MCP excelle quand la réutilisation est réelle, pas hypothétique. “On pourrait peut-être réutiliser cet outil un jour” n’est pas une justification suffisante pour ajouter un serveur MCP. Le jour où la réutilisation sera nécessaire, la migration sera simple.
Voici un guide de décision rapide :
| Question | Si oui | Si non |
|---|---|---|
| Plusieurs apps utiliseront cet outil ? | MCP | Function calling |
| L’outil a besoin d’un état persistant ? | MCP | Function calling suffit |
| L’équipe veut changer de modèle facilement ? | MCP | Function calling |
| C’est un prototype ou un one-shot ? | Function calling | Évaluer MCP |
| L’outil est simple (1-2 paramètres) ? | Function calling | MCP si réutilisé |
Les coûts cachés du MCP
Soyons honnêtes sur ce que le MCP ajoute comme complexité :
- Setup initial : il faut créer un serveur, gérer le transport, configurer les clients.
- Gestion des erreurs : les erreurs de protocole sont un vecteur de bug supplémentaire.
- Debug : quand ça ne marche pas, le diagnostic est plus complexe (le problème est-il dans le serveur, le client, le transport ou le modèle ?).
- Versioning : si le serveur MCP change, tous les clients affectés doivent être compatibles.
C’est le prix de la réutilisation et de la découplage. Si ces bénéfices ne vous concernent pas, le prix est payé pour rien.
Exemple comparatif complet
Pour bien illustrer la différence, voici le même outil “recherche dans une base de connaissances” implémenté des deux façons.
Version function calling
import openai |
Version MCP
# knowledge_server.py |
# client.py - n'importe quel client MCP |
La version MCP est plus verbeuse au niveau du client, mais le serveur est un composant réutilisable par n’importe quel client. La version function calling est plus compacte mais entièrement couplée à l’application.
L’écosystème en mouvement
En 2026, l’adoption du MCP accélère. Les principaux frameworks d’agents (LangChain, CrewAI, les SDK officiels d’OpenAI et Anthropic) supportent les deux approches. Des registres de serveurs MCP émergent, permettant de découvrir et installer des outils comme on installe des packages.
Mais le function calling reste le mécanisme fondamental. Même un client MCP, à l’intérieur, utilise du function calling pour transmettre les appels d’outils au modèle. MCP est une couche au-dessus, pas un remplacement.
Le choix entre les deux n’est pas idéologique, c’est architectural. Comme toujours en architecture logicielle, la bonne réponse est : “ça dépend”. Mais maintenant, vous avez les éléments pour décider en connaissance de cause.